جبر خطی مورد نیاز برای AI/ML (نقشه راه کامل)
12 Oct, 2026
(یادداشت: وقت خیلی کمی داشتم، پس این متن تقریباً بدون ویرایش است)
شما نیازی به PhD ریاضی برای انجام پژوهش و پروژه در حوزه ML یا AI ندارید. کافیه به اندازه لازم جبر خطی بلد باشید تا وقتی یک مقاله یا داکیومنت PyTorch باز میکنید احساس نکنید گم شدید. این نقشه راه دقیقا هر چیزی که لازم است یاد بگیرید را به ترتیب درست و اینکه چرا مهم است پوشش میدهد.
پس بیاید شروع کنیم. اصلا چرا جبر خطی؟ قبل از اینکه موضوعات را لیست کنیم، بگذارید توضیح بدهم که چرا این مساله انقدر در یادگیری ماشین مهم است. همه چیز در ML عدد است. تصاویر شبکهای از اعداد است. متن بعد از توکنایز شدن عدد میشود. صوت یک لیست از اعداد است که در طول زمان نمونهبرداری شده است. وقتی همه دادههای خود را به اعداد تبدیل میکنید، به یک راهی نیاز دارید تا:
- این اعداد را به صورت بهینه ذخیره کنید
- عملیات سریع روی آن اجرا کنید
- آنها را از یک فرم به فرم دیگر تبدیل کنید
جبر خطی در واقع زبانی برای هر سه اینهاست. شبکههای عصبی؟ فقط ضرب ماتریس هستند با کمی تابع غیرخطی به عنوان ادویه! تحلیل مولفههای اصلی (PCA)؟ مقدار ویژه(eigenvalues). سیستمهای پیشنهاددهنده(recommender systems)؟ فاکتورسازی ماتریس(matrix factorization).امبدینگ کلمات؟بردارهایی در فضای با ابعاد بالا. نمیتونید از جبر خطی فرار کنید! ولی میتونید به درک درستی از آن برسید ؛) پس بیاید شروع کنیم.
فاز ۱: اصول اولیه:
اینجا جاییه که همه باید از آن شروع کنند، حتی اگه فکر میکنید بلدشون هستین. باور کنید، برگردید و دوباره مرور کنید.
۱. اعداد(scalars)، بردارها، ماتریسها، تنسورها
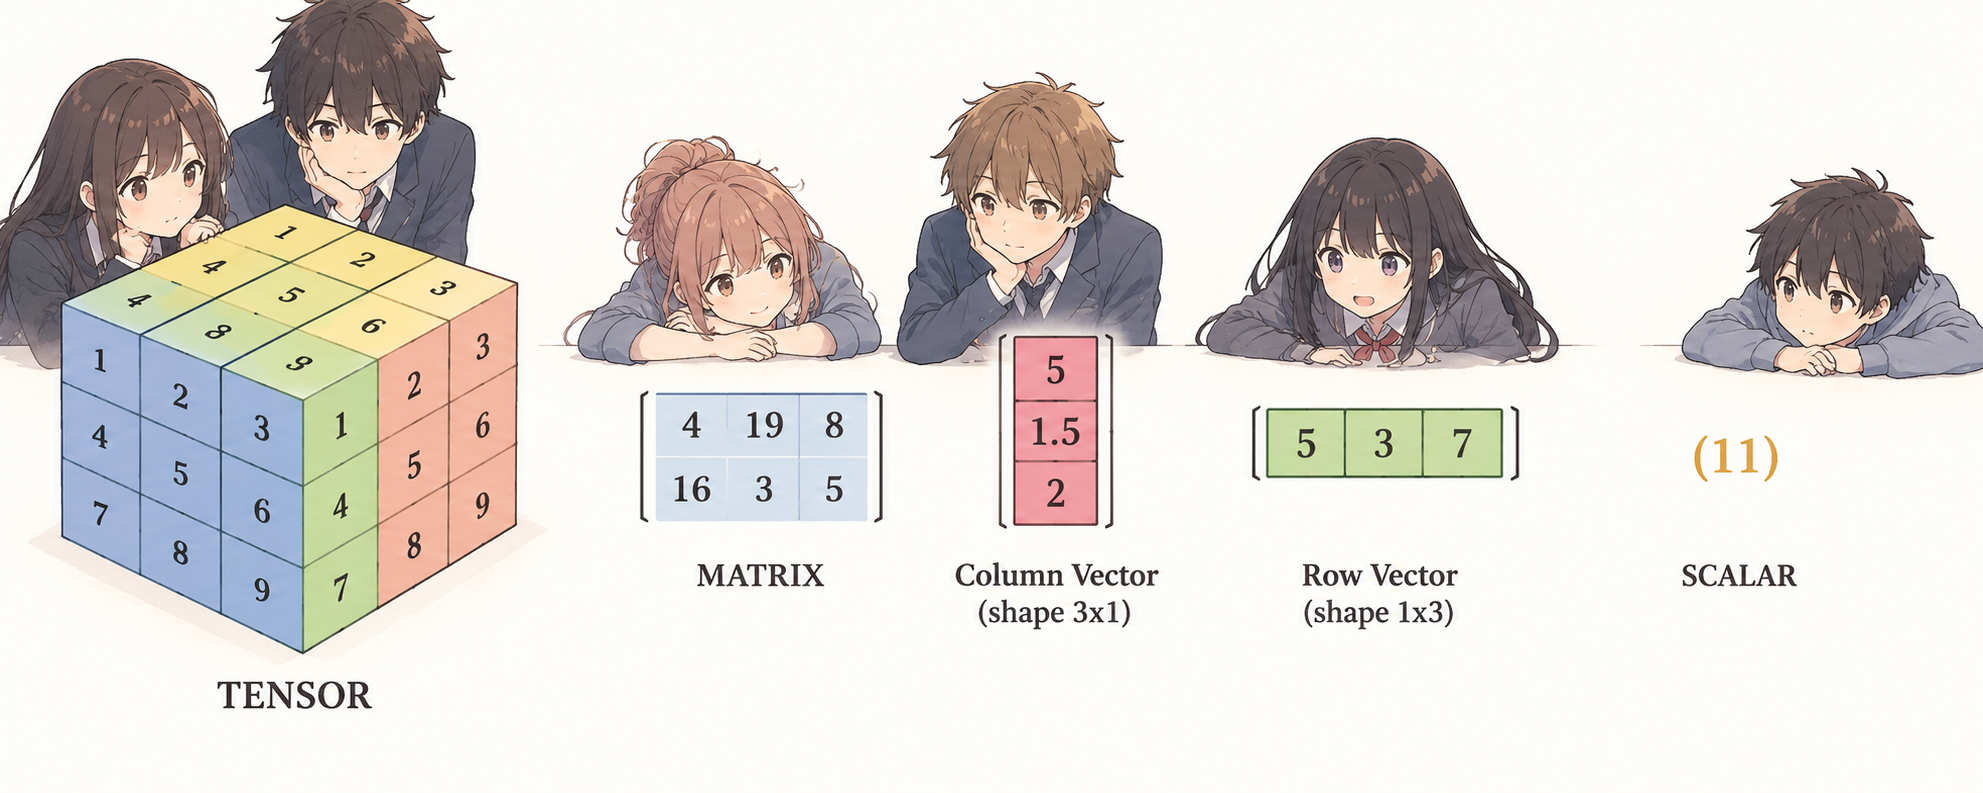 از اینجا شروع کنید و سلسله مراتب رو درک کنید.
- یک scalar فقط یک عدد است. مثل ۳.۱۴ یا ۷
- بردار یک لیست از اعداد است. مثل [1,3,5]
- ماتریس یک شبکه دو بعدی از اعداد است. اساسا متشکل از سطرها و ستونها.
- تنسور نسخه عمومی است. میتونه سه بعدی یا چهاربعدی یا بیشتر باشه. تصاویر یا batchهایی از تصاویر توی deep learning معمولا تنسورهای چهاربعدی هستند(batch, channel, height, width)
چرا اینا مهمه: هر برنامه PyTorch یا TensorFlow که مینویسید از اینها استفاده میکنه. اگه shape دیتاتون رو ندونید مجبور میشید ساعتها دیباگ کنید.
۲. عملیات برداری
یاد بگیرید چگونه:
- دو تا بردار رو با هم جمع کنید
- یک بردار رو در یک scalar ضرب کنید
- طول یک بردار (یا به عبارتی magnitude یا norm) را اندازه بگیرید
- مفهوم هندسی آن را درک کنید. یعنی مثلا یک بردار به یک جا در یک فضا اشاره میکند
به مفهوم norm دوباره و دوباره برخورد میکنید.L1 norm و L2 norm مفاهیمی هستند که در regularization و loss function استفاده میشوند.
۳. ضرب داخلی (dot product)
این یکی عظیمه:) ضرب داخلی بهتون میگه چقدر دو تا بردار شبیه هم هستند. اساس cosine similarity ضرب داخلیه که همه جا از موتورهای جستجو تا recommender systemsها تا attention های transformerها استفاده میشه.
به مقدری تمرین کنید که بتونید یه ضرب داخلی رو وقتی خوابید حساب کنید.
۴. عملیات ماتریسی
- جمع ماتریسها
- ضرب scalar در یک ماتریس
- ضرب ماتریسی (مهم)
- ترانهادن (transpose) یک ماتریس
ضرب ماتریسی ضرب آیتم به آیتم نیست. معمولا این مساله خیلی از تازهواردا رو گیج میکنه. اینجا بیشتر وقت بذارید. اینکه چرا ابعاد ماتریسها باید با هم مچ باشن (منطبق باشن) رو درک کنید. (ابعاد داخلی باید با هم بخونن، مثلا(m x n) ضرب در (n x p) میده (m x p))
فاز ۲: اجزای سازندهای که واقعا استفاده خواهید کرد
حالا میرسیم به چیزایی که واقعا تو کدهای ML بهش برمیخورین
ماتریسهای ویژه
این اسامی رو بدونید:
- identity matrix: ماتریسی که معادل با عدد ۱ است
- diagonal matrix: فقط المانهای روی قطر value دارن، بقیه صفرن
- symmetric matrix: که برابر با ترانهادش هست
- orthogonal matrix: ترانهادش برابر با معکوسش هست
اینها رو توی ماتریسهای کواریانس، ماسکهای attention و عملیات rotation میبینید.
۶. معکویس ماتریس
هر ماتریسی معکوس نداره، و اونایی که ندارن رو بهشون میگیم singular. تو ML، به ندرت معکوس ماتریس رو مستقیم محاسبه میکنیم چون هم کُنده هم پایدار نیست. یعنی میتونه خطاهای عددی رو به شدت بزرگ کنه. ولی درک مفاهیمش کمک میتونه بتونید معادلات توی مقالات رو بخونید.
بدونید دترمینان چیه و چرا دترمینان برابر با صفر یعنی معکوسناپذیر
۷. مستقل خطی و رنک
اگه یه تعداد بردار داشته باشید، آیا بعضی از اونا تکرار بقیشونن؟ این سوالیه که مفهوم مستقل خطی میپرسه. رنک یه ماتریس بهتون میگه چه تعداد از direction ها (سطرها یا ستونها) واقعا مستقل هستند.
این واسه وقتی تحلیل مولفههای اصلی(PCA) میزنید یا وقتی میشنوید میگن «دیتا روی یک خمینه (manifold) با بُعد پایینتر قرار دارن» مهمه. رنک همون ایدهایه که پشت این جمله ادایی قرار میگیره.
۸. فضای پوشانده شده(Span)، پایه(Basis)، زیرفضا(Subspace)
به Basis به چشم کوچکترین مجموعهای از بردارها ک لازم دارید تا همه چیز در یک فضا رو توضیف کنید نگاه کنید. مثل وقتی که فقط شمال-جنوب و شرق-غرب رو لازم دارید تا هر نقطهای روی یک نقشه رو بتونید توضیف کنید.
درک این مطلب وقتی میرید سراغ embedding ها کمکتون میکنه. یک امبدینگ کلمه با سایز ۷۶۸ اساسا یعنی هر کلمه به کمک یه Basis انتخاب شده تو یه فضای ۷۶۸ بعدی قرار میگیره.
فاز ۳: مسائل مهم برای ML
اوکی حالا داریم به جاهای جذاب میرسیم که هسته اصلی الگوریتمهای ML هستند.
۹. مقدارهای ویژه(eigenvalues) و بردارهای ویژه(eigenvectors)
میدونم. اسمای ترسناکین. ولی ایده پشتش سادهست. وقتی یک ماتریس را در یک بردار ضرب میکنید، معمولا اون بردار کش میاد و میچرخه. بردارهای ویژه اون بردارهای ویژهای هستند که فقط کش میان و نمیچرخن. به میزان کش اومدنشونم میگن مقدار ویژه.
چرا اصلا مهمه؟
- تحلیل مولفههای اصلی(PCA) و به طور کلی کاهش ابعاد(dimensionality reduction) از بردارهای ویژه ماتریس کواریانس استفاده میکنه
- الگوریتم اصلی گوگل (Page Rank) یک مساله بردار ویژه است
- کلاسترینگ طیفی (spectral clustering) از تجزیه ویژه (eigen-decomposition) استفاده میکنه
- درک پایداری training شبکههای اجتماعی (همگرا بودن خطا)شامل مقدارهای ویژه ماتریس Hessian است
واقعا رو این وقت بذارید. ویدیوهای 3Blue1Brown تو یوتیوب رو ببینید (رایگانه و واقعا بهترین منبع اینترنتیه برای این موضوع)
۱۰. تجزیه مقادیر منفرد/SVD (Singular Value Decomposition)
اگه قرار باشه فقط یکی از کانسپتایی که توی جبر خطی کاربردی برای ML مهمترینه رو انتخاب کنم، اون SVD هست.SVD هر ماتریسی رو (از هر shape و هر سایز) به سه تا ماتریس سادهتر میشکونه.
کاربردهاش تو ML:
- فشردهسازی ماتریسها (Low rank approximation)
- سیستمهای پیشنهاددهنده (الگوریتمهای جایزه Netflix از این استفاده کردن)
- کاهش نویز در دیتا
- درک LoRA در فاین تیون کردن مدلهای زبانی بزرگ
- محاسبات معکوسنما (Pseudoinverse computation)
اگه eigen-decomposition باحاله، SVD باحالتره چون روی هر ماتریسی کار میکنه نه فقط ماتریسهای مربعی!
۱۱. فاکتورسازی ماتریس(matrix factorization)
مربوط به SVD ولی گستردهتر. ایدهاش اینه که یه ماتریس بزرگ رو به ماتریسهای کوچکتر بشکونی که حاصل ضربشون ماتریس اصلی رو (تقریبا) برگردونه.
این کل اساس collaborative filtering هست. همینطور توی LoRA هم دیده میشه، اونجایی که آپدیت وزنها رو به عنوان ضرب دو تا ماتریس کوچکتر تقریب میزنیم تا توی مموری موقع فاین تیون کردن صرفهجویی کنیم.
۱۲. بازنگری norm ها
الان باید تو مبحث normها عمیقتر بشین:
- نرم L1 (مجموع مقادیر مطلق)، کاربرد در رگرسیون Lasso برای پراکندگی (sparsity)
- نرم L2 (همون طول معمولی)، کاربرد در رگرسیون Ridge و weight decay
- نرم Frobenius برای ماتریسها
- نرم بینهایت
هرکدوم ویژگیهای متفاوتی دارن که برای بهینهسازی و regularization مهم اند.
فاز ۴: پل بین حساب دیفرانسیل و جبرخطی
اینجا جاییه که ML واقعا اتفاق میوفته. جبر خطی محض نمیتونه یه مدل رو train کنه، ولی ترکیبش با حساب دیفرانسیل تبدیلش میکنه به gradient descent.
۱۳. گرادیانها و جاکوبیانها
گرادیان بردار مشتق جزئیه. جاکوبیان ماتریس مشتق جزئي برای تابعهای برداریه. backpropagation شبکههای عصبی لیترالی همون ضرب زنجیرهای جاکوبیان در برداره.
نیاز نیست دستی اینا رو محاسبه کنید (PyTorch با autograd اش اینکارو براتون میکنه)، ولی باید بدونید اینا بیانگر چی هستن.
۱۴. ماتریس Hessian
به ماتریس مشتق دوم میگن. مقدارهای ویژهاش بهتون در مورد انحنای تابع خطا (loss) میگن. دقیقا مثل مشتق دوم تابعهای پیوسته که تو مدرسه خوندید. متودهای بهینهسازی مرتبه دوم (مثل متود نیوتن) مستقیما ازش استفاده میکنن. برای deep learning معمولا تقریبش میزنیم چون محاسبه ماتریس Hessian کامل خیلی گرون تموم میشه.
۱۵. قانون زنجیرهای در فرم ماتریس
قانون زنجیرهای که رو ماتریسها اعمال میشه همون backprop هست. یبار که یادش بگیرید دیگه شبکههای عصبی از حالت جادو در میان و تبدیل به حساب دیفرانسیل روی ماتریسها میشن.
فاز ۵: مباحث پیشرفته (فقط برای مواقع نیاز)
پیشنهاد میکنم خیلی به این موضوعات تا وقتی بهشون برخورد نداشتین اهمیت ندین. همینکه بدونین وججود دارن کمک میکنه.
۱۶. عملیات تنسورها
- عمل Broadcasting (چگونه NumPy و PyTorch تفاوت در shape رو هندل میکنن)
- عمل Einstein summaiton (einsum)، وقتی یادش بکیرین کدهای تمیزتری مینویسین
- عمل contraction و reshape
راستشو بگم einsum واقعا سوپرپاوره. یادش بگیرید.
۱۷. اتحادهای حساب دیفرانسیل ماتریسی
چند اتحاد معروف واسه مشتقگیری از عبارات ماتریسی رایج وجو داره، از یه چیتشیت استفاده کنید واسش. مثلا pdf رایگان The Matrix Cookbook مرجع کلاسیک این موضوعه.
۱۸. ماتریسهای مثبت معین
ماتریسهایی که x^T Ax > 0 برای هر x غیر صفر. توی موضوعات زیر دیده میشه:
- ماتریسهای کواریانس (همیشه مثبت نیمه معین)
- فرایندهای گوسی
- بهینهسازی محدب (Convex optimization)
- متودهای کرنلی (Kernel methods)
۱۹. جبر خطی عددی
اینکه کامپیوترها واقعا چجوری این محاسبات رو میکنن وقتی مقیاس بزرگ میشه مهمه. موضوعاتی مثل:
- عدد وضعی (condition number)، چقدر محاسباتتون پایدار هستن
- تجزیه LU و QR
- متودهای تکرارشونده
فقط وقتی وارد این موضوعات بشید که دارید بهینهسازیهای سنگین میکنید یا دارید کد جبرخطی خودتون رو مینویسید.
فاز ۶: جایی که همه اینها در ML خودشون رو نشون میدن
بذارید بتون نشون بدم هر کدوم از این مباحثی که تا الان گفتم کجای کارهای ML میان تا قدرشو بهتر بدونین:))
رگرسیون خطی: ضرب ماتریسی، معکویس ماتریس (یا pseudoinverse با SVD)، نُرمها برای regularization
تکنیک PCA: بردارهای ویژه (eigenvectors) ماتریس کواریانس، یا SVD ماتریس دیتا
ترنسفورمرها و attention: کلی ضرب ماتریسی، ضرب داخلی برای امتیاز attention، تابع softmax روی اون امتیازها
مدلهای diffusion: تبدیلهای خطی ترکیب شده با نویز، مقدارهای ویژه (eigenvalues) در آنالیز پایداری
سیستمهای پیشنهاددهنده (recommender systems): فاکتورسازی ماتریس(matrix factorization)، SVD، تقریب low rank
شبکههای عصبی گرافی: ماتریسهای مجاورت (Adjacency matrices)، ماتریسهای لاپلاسین، eigen-decomposition (متودهای طیفی)
فاین تیون LoRA: تجزیه Low rank، لیترالی دو تا ماتریس کوچک A و B رو learn میکنید طوری که ضربشون آپدیت وزنها رو تقریب بزنه.
چگونه اینها رو واقعا یاد بگیریم
خوندن کافی نیست. باید:
- کد بزنید. ضرب ماتریسی رو از صفر با پایتون پیادهسازی کنید. روی یه عکس کوچک SVD بزنید و دوباره با اجزای کمتر بسازیدش. جلوی چشمتون ببینید کاهش ابعاد چجوری اتفاق میوفته.
-
مسائل رو اول با دست حل کنید، بعد scale کنید. یه محاسبه روی یه ماتریس 2x2 با دست بهتون بیشتر از صد بار فراخوانی np.matmul یاد میده.
- تصویرسازی کنید. دیدن سری ویدیوهای Essence of Linear Algebra از 3Blue1brown براتون اجباریه. شوخی ندارم، برید ببینیدش.
- توی پروژهها ازش استفاده کنید. یه پیشنهاددهنده ساده بسازید، یه PCA رو یه دیتاست بزنید، یه شبکه عصبی کوچیک از صفر train کنید. تئوری بدون تمرین تو یه هفته یادتون میره.
- مقالاتی که توش ریاضی داره بخونید. از سادههاش شروع کنید. مجبور کنید خودتون رو که معادلاتشم بخونید. بنویسیدشون، سعی کنید بفهمید هر کدوم از اون سمبلهای ریاضی یعنی چی.
منابعی که واقعا خوبن
- سری ویدیوهای Essence of Linear Algebra از کانال یوتیوب 3Blue1Brown: سلطان شهود تصویری
- لکچرهای MIT OCW از Gilbert Strang: خود لجند. زمان میبره ولی عالیه.
- کتاب Mathematics for Machine Learning از Deisenroth, Faisal, Ong: توی اینترنت pdf رایگانش هست، اختصاصی واسه ML نوشته شده
از کتابایی که تئوری محضن دوری کنید. باید حتما یه کانتکستی از ML داشته باشه مگه اینکه ازش لذت ببرید. زمان محدوده.
پیشنهاد آخر
سعی نکنید یکهو همه اینارو یاد بگیرید. جدی، اینکارو نکنید. برن اوت میشین و از ریاضی متنفر!
بجاش، فاز ۱ و فاز ۲ رو کامل قبل از انجام هرکار مرتبط با ML ای یاد بگیرین. بعد یه پروژه ML ساده (رگرسیون خطی از صفر). وقتی به چیزی که نمیفهمیدین برخوردین، برگردین و فار ۳ و ۴ رو یاد بگیرین. همین رو تکرار کنید.
هدف اینه که حفظ نکنید بلکه بفهمید. بفهمید چه اتفاقی داره میوفته وقتی مینویسید model.forward(x). جبرخطی بهتون اون x-ray ویژن لازم رو میده.
همینطور، حس بد نگیرین اگه ماهها طول کشید. بعضی از این چیزایی که گفتم سالها طول کشید تا واقعا بفهممش. و هنوزم گوگل میکنم بعضیاشو. همه میکنن! dumb نیستین خلاصه اگه یادتون رفت جاکوبیان چیه:)) فقط مدتیه که ازش استفاده نکردین.
ادامه بدین. بسازین. بشکنین. فیکسش کنین. این تنها راهه.
]]>